Парсинг сайтов это автоматический сбор открытых данных со страниц в таблицу или базу: цены, наличие, характеристики. Сбор открытых данных сам по себе не запрещён, но по статье 1334 ГК РФ нельзя без разрешения извлекать существенную часть чужой базы данных и использовать её дальше, а по статье 10.1 152-ФЗ обязанность доказать законность обработки общедоступных персональных данных лежит на том, кто их обрабатывает. Для разового сбора хватит сервиса или программы, для регулярного мониторинга нужен скрипт или заказной парсер с проверками. Если у источника есть API или фид, берите данные оттуда.
Парсинг сайтов это автоматический сбор данных со страниц: программа открывает страницы, находит нужные поля (название, цену, наличие, характеристики) и складывает их в таблицу или базу. Сам по себе сбор открытых данных законом не запрещён, но границы есть: нельзя без разрешения извлекать существенную часть чужой базы данных и использовать её дальше, нельзя собирать персональные данные без законного основания, нельзя обходить защиту и перегружать чужой сервер. Парсить можно облачным сервисом, программой на компьютере, скриптом на Python или заказать сбор у разработчика: выбор зависит от объёма, частоты и того, насколько часто сайты-источники меняются.
Ниже разберём, как устроен парсинг, для каких задач он нужен бизнесу, что говорят о нём Гражданский кодекс и закон о персональных данных, чем парсить в разных ситуациях, почему сбор ломается и как посчитать, окупится ли мониторинг цен.
Что такое парсинг простыми словами
Представьте сотрудника, который каждое утро открывает сайты конкурентов, ищет нужные товары и переписывает цены в таблицу. Парсер делает то же самое, только быстрее и без усталости. Слово пришло от английского parse, «разбирать»: программа разбирает код страницы и достаёт из него нужные кусочки.
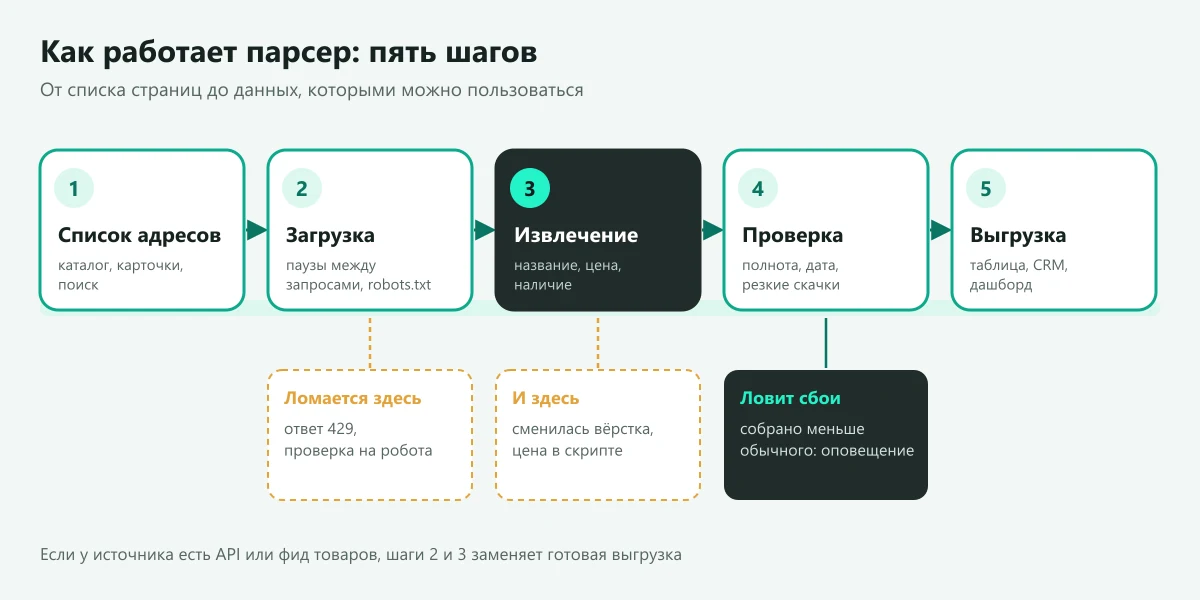
Любой парсер проходит пять шагов:
- Список адресов. Какие страницы открывать: каталог, карточки товаров, результаты поиска.
- Загрузка страниц. Запрос к сайту с паузами между запросами, чтобы не создавать нагрузку.
- Извлечение полей. Программа находит на странице название, цену, наличие по заранее заданным правилам.
- Проверка и очистка. Убрать пустые и странные значения, привести цены к числу, отметить дату сбора.
- Выгрузка. Таблица, база, CRM или дашборд с мониторингом цен.
Рядом с парсингом часто стоит слово «API». Если у сайта или поставщика есть API или готовый файл выгрузки (например, фид товаров в формате YML или CSV), берите данные оттуда: это законный, стабильный и быстрый способ, который не ломается от смены дизайна.
Для чего бизнесу парсинг
Парсинг нужен там, где данные открыто лежат на чужих сайтах, а собирать их руками долго. Самые частые задачи:
| Задача | Какие данные | Как часто обычно собирают |
|---|---|---|
| Мониторинг цен конкурентов | Цена, скидка, наличие по вашим позициям | Раз в сутки или реже, ходовые позиции чаще |
| Каталоги поставщиков | Новые товары, характеристики, остатки | По графику обновления поставщика |
| SEO-аудит своего сайта | Заголовки, ответы сервера, битые ссылки, дубли | Перед запуском и после крупных изменений |
| Анализ ассортимента рынка | Какие товары и услуги есть у конкурентов | Раз в месяц или квартал |
| Отзывы о своей компании | Тексты, оценки, даты на площадках | Раз в день или неделю |
Частота стоит денег: чем чаще собираете, тем больше запросов, блокировок и поддержки. Как выбрать частоту для мониторинга цен и не платить за лишнее, подробно разобрано в статье почему парсинг цен работает нестабильно.
Законно ли парсить сайты
Короткий ответ: сбор открытых данных сам по себе не запрещён, но законность зависит от того, что именно вы собираете, в каком объёме и как используете. Ниже то, что прямо написано в законах. Это не юридическая консультация: если задача касается чужой базы целиком или данных о людях, покажите её юристу до запуска.
Права изготовителя базы данных: статья 1334 ГК РФ
Тот, кто вложил существенные затраты в создание базы данных, получает исключительное право извлекать из неё материалы и использовать их. По статье 1334 Гражданского кодекса никто не вправе без разрешения правообладателя извлекать из такой базы материалы и осуществлять их последующее использование. Извлечением закон называет перенос всего содержания базы или существенной части её материалов на другой носитель любыми техническими средствами. Если в базе не меньше десяти тысяч самостоятельных элементов, затраты на её создание считаются существенными, пока не доказано иное.
Каталог крупного интернет-магазина или доски объявлений легко попадает под это описание. Поэтому риск выше, когда вы копируете чужой каталог целиком или большую его часть и публикуете у себя, и ниже, когда собираете цены по своим позициям для внутреннего анализа.
Персональные данные: статья 10.1 закона 152-ФЗ
Имена, телефоны, профили людей это персональные данные, даже если они видны всем. Статья 10.1 закона о персональных данных говорит: если данные стали общедоступными без согласия человека на их распространение, обязанность доказать законность распространения или иной обработки лежит на каждом, кто их распространил или обработал. Для бизнеса вывод простой: не собирайте данные о людях парсером, если у вас нет понятного законного основания.
Правила сайта, robots.txt и нагрузка
Файл robots.txt описывает, какие разделы владелец сайта просит не обходить роботам. Стандарт RFC 9309 прямо говорит, что эти правила не являются механизмом авторизации доступа, то есть технически они ничего не запрещают. Но это ясно выраженная воля владельца, и её стоит соблюдать, как и пользовательское соглашение сайта. Отдельно про нагрузку: частые запросы без пауз мешают работе чужого сайта, а обход капчи, авторизации и других защит выходит за рамки сбора открытых данных. Когда данные нужно переносить через окна программ, помогают программные роботы, они разобраны в статье RPA: что это.
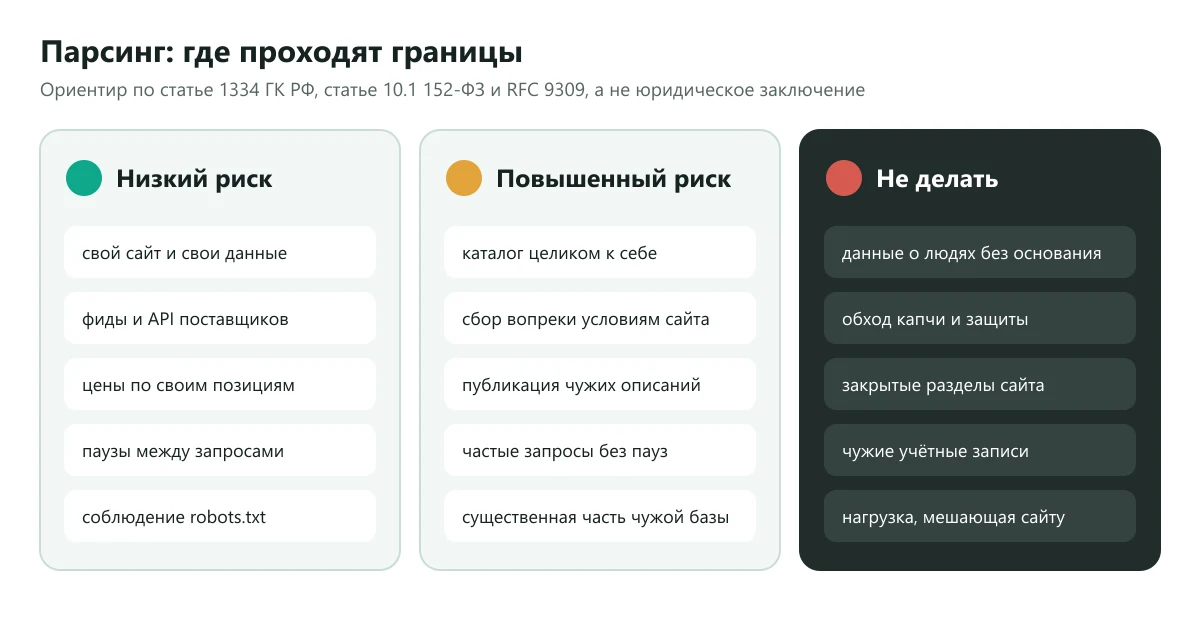
Что не делать никогда. Собирать персональные данные без основания, обходить капчу и авторизацию, собирать из закрытых разделов по чужим учётным записям, создавать нагрузку, которая мешает сайту работать. Ни один инструмент из обзора ниже этого не оправдывает.
Если парсинг нужен для автоматической реакции на цены конкурентов, есть ещё и антимонопольная сторона вопроса. Она разобрана в статье о мониторинге цен конкурентов и контроле человека.
Чем парсить: четыре варианта
Инструмент выбирают по трём вопросам: сколько страниц, как часто и кто будет чинить сбор, когда сайт-источник поменяется. Переключайте вкладки.
- Что это: облачные конструкторы и расширения браузера, где поля для сбора выбирают мышкой.
- Подходит: разовый сбор с одного-двух простых сайтов, проверка гипотезы.
- Подвох: при смене вёрстки настройку чинить вам; лимиты тарифа быстро заканчиваются на больших каталогах.
- Цены: у каждого сервиса свои тарифы и лимиты, сравнивайте их на официальных страницах перед выбором.
- Что это: программы-краулеры, которые обходят сайт и собирают данные страниц.
- Подходит: SEO-аудит своего сайта, сбор заголовков, ответов сервера, ссылок.
- Пример цены: Screaming Frog SEO Spider бесплатен до 500 адресов, лицензия стоит £199 в год (официальный сайт, октябрь 2026).
- Подвох: работает на одном компьютере и по запуску человека, для ежедневного мониторинга неудобно.
- Что это: скрипты на библиотеках с открытым кодом, например Scrapy для обхода сайтов и BeautifulSoup для разбора страниц.
- Подходит: регулярный сбор с нескольких сайтов, своя логика проверок, выгрузка куда угодно.
- Плюс: в Scrapy есть расширение AutoThrottle, которое само подстраивает скорость запросов под нагрузку на сайт.
- Подвох: скрипт живёт, пока его кто-то поддерживает; без разработчика сбор встанет при первом редизайне источника.
- Что это: парсер под вашу задачу с сопоставлением товаров, проверками, журналом и выгрузкой в CRM или дашборд.
- Подходит: данные нужны каждый день и от них зависят решения по ценам и закупкам.
- Что проверить в договоре: срок починки при изменении источника, оповещения о сбоях, кому принадлежит код.
- Подвох: без понятного задания подрядчик соберёт «всё подряд», а вам нужны 50 ключевых позиций.
Если у источника есть API или файл выгрузки, берите данные оттуда: это стабильнее любого парсера и не зависит от дизайна сайта.
| Ситуация | Что подойдёт |
|---|---|
| Разово собрать данные с одного простого сайта | Облачный сервис или расширение браузера |
| Проверить свой сайт перед запуском | Программа-краулер для SEO-аудита |
| Регулярно собирать цены с 5–20 сайтов | Скрипт на Python у своего разработчика или заказной парсер |
| Данные нужны в CRM, учёте или дашборде каждый день | Заказная разработка с проверками и журналом |
Почему парсинг ломается и как сделать его устойчивым
Парсер зависит от чужого сайта, который не обещал вам ничего не менять. Основные причины сбоев:
- Сменилась вёрстка. Цена переехала в другой блок, и парсер молча собирает пустоту.
- Блокировки. Сайт отвечает кодом 429 «слишком много запросов» или показывает проверку на робота.
- Данные подгружаются скриптом. В исходном коде страницы цены нет, она появляется после выполнения JavaScript.
- Разные карточки. У части товаров другая разметка, варианты, цена «от».
Устойчивость дают не хитрые обходы, а проверки: сколько страниц собрано из запланированных, у каждой цены дата сбора, резкий скачок цены перепроверяется, пауза после ответа 429. Сложность сбора сильно зависит от типа сайта-источника, ниже пример оценки.
Как оценено в примере: учитывалось, нужен ли запуск JavaScript, как часто меняется вёрстка и насколько разнородны карточки. 1–3: хватит простого скрипта и проверки полноты. 4–8: закладывайте поддержку и оповещения о сбоях. «Стоп»: закрытые разделы и защиту не обходят, такие данные запрашивают у владельца.
Что делать с собранными данными
Собрать цены мало, нужно, чтобы ими пользовались. Сырые данные парсера почти всегда требуют трёх доработок:
- Сопоставление товаров. «Дрель X 800 Вт» у конкурента и «Дрель X-800» у вас это одна позиция или нет. Надёжнее всего сопоставлять по артикулу производителя или штрихкоду, а спорные пары подтверждать вручную один раз и хранить в таблице соответствий.
- История. Храните не только текущую цену, но и все прошлые значения с датой сбора. Без истории нельзя понять, это акция на два дня или новая постоянная цена.
- Адресат. Решите заранее, кто смотрит данные и что делает при изменении: категорийный менеджер, закупщик, руководитель продаж. Отчёт, который никто не открывает, это расходы без пользы.
Удобный формат для ежедневной работы: короткая сводка «что изменилось со вчера» по вашим ключевым позициям и экран с историей цен для разбора. Полный дамп каталога конкурента в таблице на десять тысяч строк обычно никто не читает.
Окупится ли мониторинг цен
Парсинг цен окупается, если быстрая реакция на цену конкурента реально удерживает заказы. Проверьте это на своих цифрах: какая доля заказов зависит от цены и какую часть из них вы теряете, когда узнаёте об изменении слишком поздно.
Как считается: заказы, где решает цена = заказы в месяц × их доля; удержанные = такие заказы × доля, которую удаётся удержать благодаря вовремя изменённой цене; прибыль = удержанные заказы × средний чек × маржа − сервер и поддержка. Отладка учитывает, что первые недели сбор работает не на всех позициях. Снижение собственной маржи при ответном снижении цены в расчёт не входит: учтите его, уменьшив маржу.
Как заказать парсинг и что прописать в задании
Хорошее задание на парсинг помещается на одну страницу и отвечает на вопросы:
- Какие сайты и разделы, примеры адресов страниц.
- Какие поля собирать и в каком виде: цена с учётом скидки или без, наличие, единица измерения.
- Как сопоставлять товары с вашими: по артикулу, штрихкоду или вручную подтверждённым парам.
- Как часто собирать и к какому часу данные должны быть готовы.
- Куда выгружать: таблица, база, CRM, дашборд.
- Какие проверки обязательны: полнота сбора, дата у каждой записи, оповещение при сбое.
- Правила: паузы между запросами, соблюдение robots.txt и условий сайтов, без персональных данных.
- Кто и в какой срок чинит сбор, когда сайт-источник меняется.
Последний пункт самый важный: парсер без поддержки перестаёт работать при первом редизайне источника. Если не хотите держать эту задачу у себя, посмотрите, как устроены услуги парсинга с проверками и дашбордами. Когда собранные данные нужно автоматически передавать в CRM, учёт или на сайт, это уже задача интеграции через API.
Что сделать на этой неделе
- Выпишите, какие данные сотрудники сейчас собирают с чужих сайтов руками и сколько времени на это уходит.
- Проверьте, нет ли у источника API или файла выгрузки: это лучше любого парсера.
- Уберите из задачи всё, что касается данных о людях.
- Для мониторинга цен выберите 50 главных позиций и посчитайте окупаемость на них, прежде чем собирать весь каталог.
- Гражданский кодекс РФ, статья 1334 «Исключительное право изготовителя базы данных», КонсультантПлюс
- Федеральный закон № 152-ФЗ, статья 10.1 о персональных данных, разрешённых для распространения, КонсультантПлюс
- RFC 9309: Robots Exclusion Protocol (правила не являются авторизацией доступа)
- Screaming Frog SEO Spider: цена лицензии и лимит бесплатной версии (проверено в октябре 2026)
- Документация Scrapy: расширение AutoThrottle
Частые вопросы
Законно ли парсить сайты конкурентов?
Сбор открытых данных сам по себе законом не запрещён, но есть границы. По статье 1334 ГК РФ нельзя без разрешения извлекать всю или существенную часть чужой базы данных и использовать её дальше. Нельзя собирать персональные данные без основания и обходить защиту сайта. В спорных случаях покажите задачу юристу до запуска.
Можно ли парсить телефоны и контакты людей?
Это персональные данные, даже если они опубликованы. По статье 10.1 152-ФЗ, если данные стали общедоступными без согласия человека на распространение, доказывать законность обработки должен тот, кто их обрабатывает. Для бизнеса безопаснее такие данные парсером не собирать.
Обязательно ли соблюдать robots.txt?
Стандарт RFC 9309 прямо говорит, что правила robots.txt не являются механизмом авторизации доступа. Но это выраженная воля владельца сайта, поэтому добросовестный парсер её соблюдает вместе с пользовательским соглашением и не создаёт лишней нагрузки.
Какой программой парсить сайт без программирования?
Для разового сбора подойдут облачные сервисы и расширения браузера, где поля выбирают мышкой. Для аудита своего сайта есть программы-краулеры: например, Screaming Frog SEO Spider бесплатен до 500 адресов. Для регулярного сбора с нескольких сайтов понадобится разработчик или заказной парсер.
Почему парсер перестал собирать цены?
Чаще всего сайт-источник поменял вёрстку, начал отвечать ошибкой 429 из-за частых запросов или стал подгружать цену скриптом. Защита от тихих сбоев: проверка полноты сбора, дата у каждой цены и оповещение, когда собрано меньше обычного.
Как часто нужно собирать цены конкурентов?
Не чаще, чем вы готовы менять свои цены. Обычно ходовые позиции собирают раз-два в сутки, основной ассортимент раз в сутки или реже, длинный хвост раз в неделю. Подробная методика есть в статье блога о нестабильном парсинге цен.
Что лучше: парсинг или API?
Если у источника есть API или файл выгрузки, например фид товаров, берите данные оттуда. Это законный, стабильный и быстрый способ, который не ломается от смены дизайна. Парсинг нужен, когда такого канала нет.