Локальная нейросеть это языковая модель, которая работает на вашем компьютере или сервере, поэтому запросы и документы не уходят во внешний сервис. Нужны файл модели, программа запуска вроде Ollama или LM Studio и интерфейс для сотрудников. Главное требование к железу это память: модель должна поместиться в видеопамять с запасом на текст разговора, размер файла указан на странице модели. Лицензии разные: Qwen3 и Gemma 4 выходят под Apache 2.0, у Llama 3.1 своя лицензия с условиями. Локальный запуск снимает вопросы передачи персональных данных внешнему сервису, но остальные обязанности по 152-ФЗ остаются.
Локальная нейросеть это языковая модель, которая работает на вашем компьютере или сервере, а не в облаке чужой компании. Вопросы, документы и ответы никуда не уходят: интернет нужен только для того, чтобы один раз скачать модель. Для бизнеса это способ пользоваться ИИ для писем, договоров и внутренних справок, не отправляя данные клиентов во внешний сервис. Ниже разберём, какое железо нужно, какие модели можно брать и что разрешают их лицензии, как запустить нейросеть по шагам и в каких случаях облачный сервис всё же выгоднее.
Что такое локальная нейросеть простыми словами
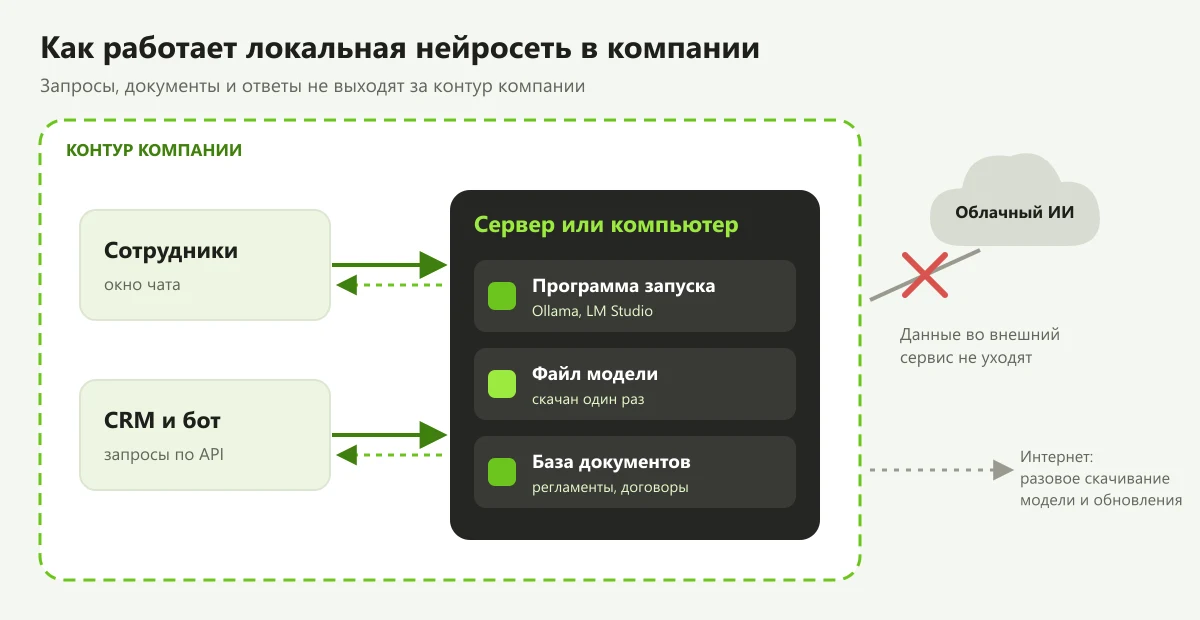
Локальная нейросеть это файл модели и программа, которая его запускает, на технике, которой распоряжаетесь вы. Когда вы пишете запрос в облачный чат-бот, текст уходит на серверы разработчика, там обрабатывается и возвращается ответом. В локальном варианте весь путь проходит внутри вашего компьютера или офисной сети.
Работает это так:
- Модель. Файл с «весами» нейросети размером от одного до десятков гигабайт. Её скачивают с официальной страницы разработчика или из библиотеки программы запуска.
- Программа запуска. Загружает модель в память, принимает запросы и выдаёт ответы. Самые известные варианты: Ollama и LM Studio. Ollama распространяется под открытой лицензией MIT и работает в macOS, Windows и Linux.
- Интерфейс. Окно чата для сотрудников или программный интерфейс (API), через который к модели подключаются CRM, бот или внутренняя система.
Важная оговорка: надпись «локальная» относится к модели, а не ко всей программе. Некоторые программы умеют подключать и облачные модели. Например, в библиотеке Ollama есть варианты с пометкой cloud: они выполняются не на вашем компьютере. Проверяйте, что именно вы запускаете.
Зачем бизнесу запускать ИИ у себя
Главная причина одна: данные остаются внутри компании. Остальные плюсы приятны, но вторичны, а минусы стоит знать до покупки железа.
| Что сравниваем | Локальная модель | Облачный сервис |
|---|---|---|
| Где обрабатываются данные | На вашем компьютере или сервере | На серверах провайдера |
| Нужен ли интернет | Только для скачивания модели | Постоянно |
| Оплата | Железо, электричество, настройка | Подписка или оплата за запросы |
| Качество ответов | Зависит от размера модели, которую потянет железо | Обычно доступны самые сильные модели |
| Скорость | Зависит от видеокарты и памяти | Зависит от провайдера и нагрузки |
| Кто обновляет и чинит | Вы или ваш подрядчик | Провайдер |
Честный вывод: локальная нейросеть выигрывает там, где данные нельзя или не хочется отдавать наружу, а задачи типовые. Для сложных рассуждений, длинных текстов и работы без технического сопровождения облако часто проще. Подробнее о том, какие ИИ-инструменты есть и как начать с ними работать, рассказано в статье об ИИ-инструментах для бизнеса.
Где можно запустить нейросеть: четыре варианта
Запустить модель можно на компьютере сотрудника, на сервере в офисе, на арендованном сервере или вовсе не запускать, а подключить облачный сервис. От выбора зависят безопасность, скорость и то, сколько людей смогут работать одновременно.
| Вариант | Кому подходит | Плюсы | Минусы |
|---|---|---|---|
| Компьютер сотрудника | Проба, один-два пользователя | Быстрый старт, ничего не покупать | Модель занимает ресурсы, другим недоступна |
| Сервер в офисе | Отдел или вся компания, строгие требования к данным | Данные не покидают офис | Покупка железа, охлаждение, резервное питание, обслуживание |
| Арендованный сервер с видеокартой | Компании без серверной, с филиалами | Не нужно покупать железо, доступ из любого офиса | Данные у хостинга, нужно настроить защиту доступа |
| Облачный ИИ-сервис | Задачи без чувствительных данных | Сильные модели, ничего не обслуживать | Данные уходят провайдеру, оплата за использование |
Какое железо нужно для локальной нейросети
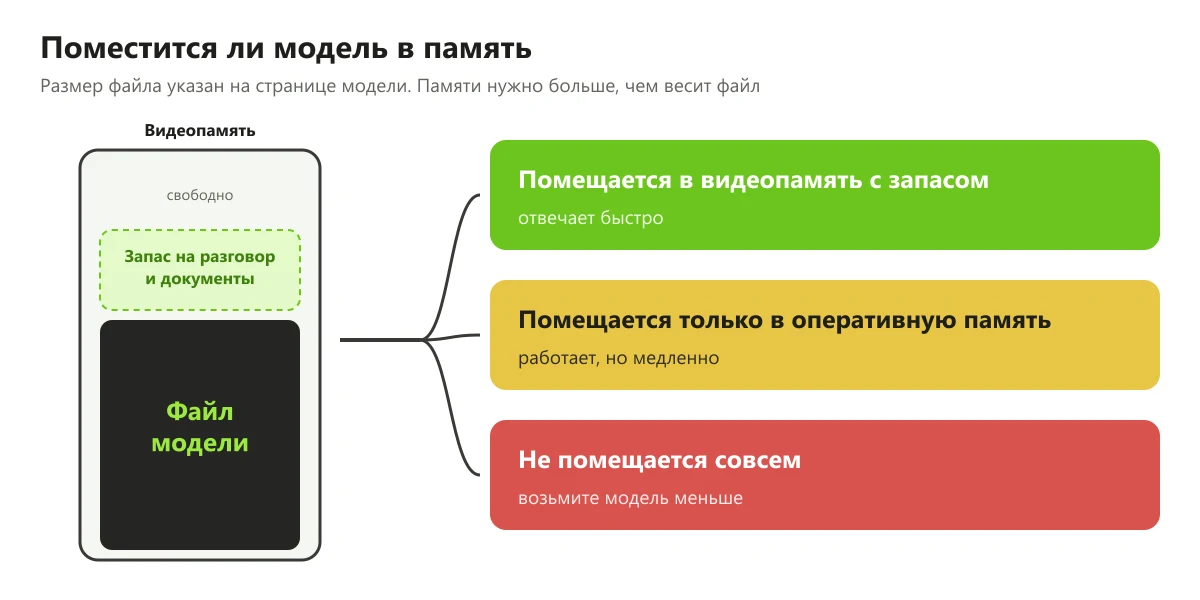
Главное требование к железу это память: модель должна целиком поместиться в видеопамять или оперативную память, и ещё нужен запас на сам разговор. Процессор и диск важны меньше.
Разработчики моделей обычно не пишут точных требований к компьютеру. Зато в библиотеке Ollama для каждой модели указан размер файла. Это нижняя граница: памяти нужно больше, чем весит файл, потому что во время работы модель хранит ещё и текст текущего разговора. Чем длиннее документ, тем больше запас.
Как читать: если файл модели с запасом помещается в видеопамять вашей видеокарты, модель будет отвечать быстро. Если нет, она запустится на процессоре и оперативной памяти, но медленнее. Самая большая версия Qwen3 весит 142 ГБ и рассчитана на серверы с несколькими видеокартами. Перед скачиванием сверяйте размер на странице модели: он меняется с обновлениями.
Как прикинуть, что подойдёт вам:
- Посмотрите на странице модели размер файла нужной версии.
- Сравните его с объёмом видеопамяти видеокарты. Если файл помещается с запасом, модель будет работать на видеокарте быстро.
- Если видеопамяти не хватает, модель запустится на процессоре и оперативной памяти, но ответы будут идти заметно медленнее.
- Проверьте скорость на своих реальных задачах, а не на вопросе «привет». Длинный договор нагружает модель сильнее короткого письма.
Разработчики Gemma 4 пишут, что семейство рассчитано на устройства от мощных телефонов до ноутбуков и серверов, а версии 12B, 26B и 31B предназначены для потребительских видеокарт и рабочих станций. Это хороший ориентир: для типовых офисных задач часто хватает модели среднего размера на одной видеокарте.
Какие модели можно взять и что разрешают их лицензии
Для бизнеса важна не только сила модели, но и лицензия: она определяет, можно ли использовать модель в коммерческих целях и встраивать в свои сервисы. Лицензии у популярных открытых моделей разные.
| Семейство | Лицензия | На что обратить внимание |
|---|---|---|
| Qwen3 (Alibaba) | Apache 2.0, по данным страницы модели | Разрешительная лицензия, коммерческое использование допускается. Заявлена поддержка более 100 языков |
| Gemma 4 (Google) | Apache 2.0, по данным страницы модели | Ранние версии Gemma выходили под отдельными условиями использования, у каждой версии проверяйте свою лицензию |
| Llama 3.1 (Meta) | Собственная лицензия Llama 3.1 Community License | Требует указывать «Built with Llama», соблюдать правила допустимого использования, а при аудитории больше 700 млн активных пользователей в месяц нужна отдельная лицензия |
Лицензии меняются от версии к версии, поэтому смотрите условия на странице именно той модели и версии, которую скачиваете. Если собираетесь встроить модель в продукт для клиентов, покажите лицензию юристу.
Качайте модели только из официальных источников. Страница разработчика или официальная библиотека программы запуска. Модель из случайного архива может вести себя непредсказуемо, а программы «в комплекте» с ней бывают опасны.
Как запустить локальную нейросеть: пошагово
Запустить первую модель можно за вечер. Ниже порядок на примере Ollama, у других программ шаги похожи.
- Установите программу запуска с официального сайта или из официального репозитория.
- Выберите модель под объём памяти. Для пробы подойдёт модель среднего размера, например «qwen3:8b»: в библиотеке Ollama её файл весит 5,2 ГБ.
- Скачайте и запустите командой «ollama run qwen3:8b». После скачивания интернет для работы не нужен.
- Проверьте на своих задачах. Возьмите 20 реальных писем или фрагментов договоров без персональных данных и оцените ответы.
- Подключите интерфейс для сотрудников: веб-чат или связку с вашей CRM через API.
- Настройте доступ. По документации Ollama сервер по умолчанию слушает только локальный адрес 127.0.0.1 и порт 11434. Открывать его в сеть можно только за защитой: с паролем, ограничением адресов и журналом обращений.
Если нужно, чтобы модель отвечала по вашим регламентам и документам, к ней подключают поиск по базе знаний. Это отдельная настройка: модель сама по себе ваших документов не знает. Такие ассистенты на данных компании мы собираем в рамках услуги ИИ-ассистента для бизнеса, в том числе на своём сервере заказчика.
Локальная нейросеть и персональные данные
Локальный запуск снимает главный риск: персональные данные клиентов и сотрудников не уходят во внешний сервис. Но обязанности по закону о персональных данных от этого не исчезают.
- Передача третьему лицу. Если вы отправляете персональные данные в облачный ИИ-сервис, их обрабатывает другая компания. По 152-ФЗ для этого нужно законное основание и, как правило, поручение обработки. Локальная модель этот вопрос снимает.
- Трансграничная передача. Если серверы сервиса за рубежом, по статье 12 152-ФЗ оператор должен заранее уведомить Роскомнадзор. Локальная модель на сервере в России такой передачи не создаёт.
- Что остаётся. Цели обработки, защита сервера, доступы сотрудников, журнал действий, удаление данных по сроку. Это те же требования, что и к любой вашей системе.
Это общие ориентиры, а не юридическая консультация. Схему работы с персональными данными в ИИ проверьте с юристом. Что подготовить до пилота, если ИИ работает с конфиденциальными данными, разобрано в статье об ИИ и персональных данных.
Что поручить локальной модели в компании
Лучше всего локальные модели справляются с типовой работой над текстом, где ответ легко проверить. Вот примеры задач для небольшой компании.
| Задача | Почему подходит локальная модель | Кто проверяет |
|---|---|---|
| Черновики ответов клиентам | В письмах персональные данные и детали заказов | Менеджер перед отправкой |
| Краткое содержание договора | Коммерческая тайна не уходит наружу | Юрист или руководитель |
| Поиск по регламентам и инструкциям | Внутренние документы остаются в компании | Сотрудник по ссылке на документ |
| Разбор входящих заявок по темам | Контакты клиентов не покидают сеть | Выборочная проверка раз в неделю |
| Расшифровка и конспект совещаний | Обсуждения не попадают к провайдеру | Участник совещания |
Задачи, где ошибка дорого стоит, оставляйте с обязательной проверкой человеком. Модель может уверенно выдумать пункт договора, которого нет.
Как проверить качество модели до запуска
Качество проверяют на своих задачах, а не по рейтингам из интернета. Модель, которая хорошо пишет код на английском, может слабо справляться с русскими договорами.
- Соберите набор из 20–30 реальных примеров. Письма, фрагменты договоров, вопросы сотрудников. Уберите или замените персональные данные, если пробуете не на своём сервере.
- Запишите эталонные ответы. Как бы ответил опытный сотрудник. Это займёт час, но без эталона оценка будет на глаз.
- Прогоните набор через две-три модели разного размера. Отметьте для каждого ответа: годится сразу, годится после правки, не годится.
- Засеките время ответа. Если сотрудник ждёт минуту на каждое письмо, он вернётся к ручной работе.
- Выберите самую маленькую модель, которая проходит порог. Например, 7 из 10 ответов годятся после небольшой правки. Меньшая модель быстрее и дешевле в железе.
Этот же набор пригодится потом: прогоняйте его после каждого обновления модели, чтобы качество не просело незаметно.
Окупится ли локальная нейросеть
Локальная модель окупается, когда задач много и они повторяются. Если задач десяток в неделю, расходы на сервер и обслуживание не вернутся, и разумнее облачный сервис для обезличенных данных.
Как считается: экономия в месяц = задачи × доля, которую можно отдать модели × доля годных ответов × стоимость времени на задачу × доля сэкономленного времени, минус обслуживание. Стоимость задачи в первом примере: 30 минут при часе сотрудника 800 ₽, во втором и третьем 20 минут при часе 900 ₽. Время на проверку ответа уже учтено в доле экономии. Подставьте свои цифры после пробы на реальных задачах.
Чек-лист: готовы ли вы к локальной нейросети
Отметьте, что уже сделано. Чек-лист подходит и для проверки уже запущенной модели.
Частые ошибки
- Купить железо до проверки задач. Сначала проверьте модель на компьютере с подходящей видеокартой или на арендованном сервере, потом покупайте.
- Взять самую большую модель. Она не поместится в память и будет отвечать минутами. Начните со средней.
- Открыть сервер модели в интернет без защиты. Любой, кто найдёт адрес, сможет пользоваться вашей моделью и нагружать сервер.
- Не прочитать лицензию. Особенно если модель будет работать в сервисе для клиентов.
- Ждать, что модель знает ваши документы. Без подключённой базы знаний она отвечает из общих знаний и может ошибаться.
- Не назначить ответственного. Модели и программы обновляются, сервер нужно обслуживать и делать резервные копии настроек.
Локальная нейросеть это рабочий инструмент для компаний, которым важно держать данные при себе. Начните с одной задачи, средней модели и честной проверки на реальных документах. Если результат устраивает и задач много, переносите модель на сервер и подключайте к своим системам.
- Ollama: репозиторий, лицензия MIT и поддерживаемые системы
- Документация Ollama, FAQ: адрес и порт по умолчанию, OLLAMA_HOST, конфиденциальность
- Библиотека Ollama: версии Qwen3 и размеры файлов
- Hugging Face: страница модели Gemma 4 31B, лицензия Apache 2.0 и назначение версий
- Лицензия Llama 3.1 Community License
- Федеральный закон № 152-ФЗ «О персональных данных» (КонсультантПлюс)
Частые вопросы
Что такое локальная нейросеть?
Это языковая модель, которая работает на вашем компьютере или сервере. Запросы и документы обрабатываются внутри компании, а интернет нужен только для скачивания модели и обновлений.
Какой компьютер нужен для локальной нейросети?
Главное это память. Файл модели должен поместиться в видеопамять с запасом на текст разговора, размер файла указан на странице модели. Если видеопамяти не хватает, модель запустится на процессоре, но будет отвечать медленнее.
Можно ли использовать открытые модели в коммерческих целях?
Зависит от лицензии конкретной версии. Qwen3 и Gemma 4 выходят под Apache 2.0, она разрешает коммерческое использование. У Llama 3.1 своя лицензия с требованием указывать «Built with Llama» и правилами допустимого использования. Перед встраиванием модели в продукт покажите лицензию юристу.
Локальная нейросеть хуже ChatGPT?
Самые сильные модели обычно доступны только в облаке, а локальная модель ограничена вашим железом. Для типовых задач вроде черновиков писем, конспектов и поиска по документам модели среднего размера часто хватает. Проверяйте на своих задачах.
Нужно ли соблюдать 152-ФЗ, если нейросеть локальная?
Да. Локальный запуск снимает вопросы передачи данных внешнему сервису и трансграничной передачи, но цели обработки, защита сервера, доступы и сроки хранения остаются. Схему работы проверьте с юристом.
Можно ли научить локальную нейросеть отвечать по документам компании?
Да, для этого к модели подключают поиск по базе знаний: модель получает нужные фрагменты документов вместе с вопросом. Сама по себе модель ваших документов не знает.
Безопасно ли открыть локальную нейросеть для всего офиса?
Да, если настроить защиту. По умолчанию Ollama принимает запросы только с того же компьютера. Для доступа по сети нужны пароль, ограничение адресов и журнал обращений, а открывать сервер в интернет без защиты нельзя.